我参与过简历筛查和面试。逐份读简历,再去找里面提到的项目,我觉得挺枯燥的。于是我在业余时间做了 ResumeRadar,让 AI 先读简历、搜索公开项目,再整理成初筛报告,帮我更快地看材料。
从简历到初筛报告
投递记录和简历从飞书多维表格接入,也可以手动添加。工具读取简历,扫描件先用 OCR 转成文字。接着结合岗位 JD 做初评,同时提取项目、链接和可以公开查询的信息,交给后续阶段搜索、核查,最后汇总成报告。
我把读取、初评、核查、开源评审和出面试题拆成独立阶段,各自保存结果。多条信息可以并行核查,后面的阶段复用已有结果。需要调整时,只重跑相关部分。
查询简历里的公开项目
简历提供了公开链接或项目线索,就让 AI 帮我搜索、打开页面,把读到的内容和简历里的描述放在一起看。报告保留来源、摘录和核查结果,方便我继续查看。
GitHub 项目会优先看简历明确提到的仓库。候选人自己的项目,就读 README、近期提交,再按岗位挑相关代码;参与别人的项目,就看本人提交的 PR 和改动。账号是不是本人、具体贡献了什么,也需要一起确认。
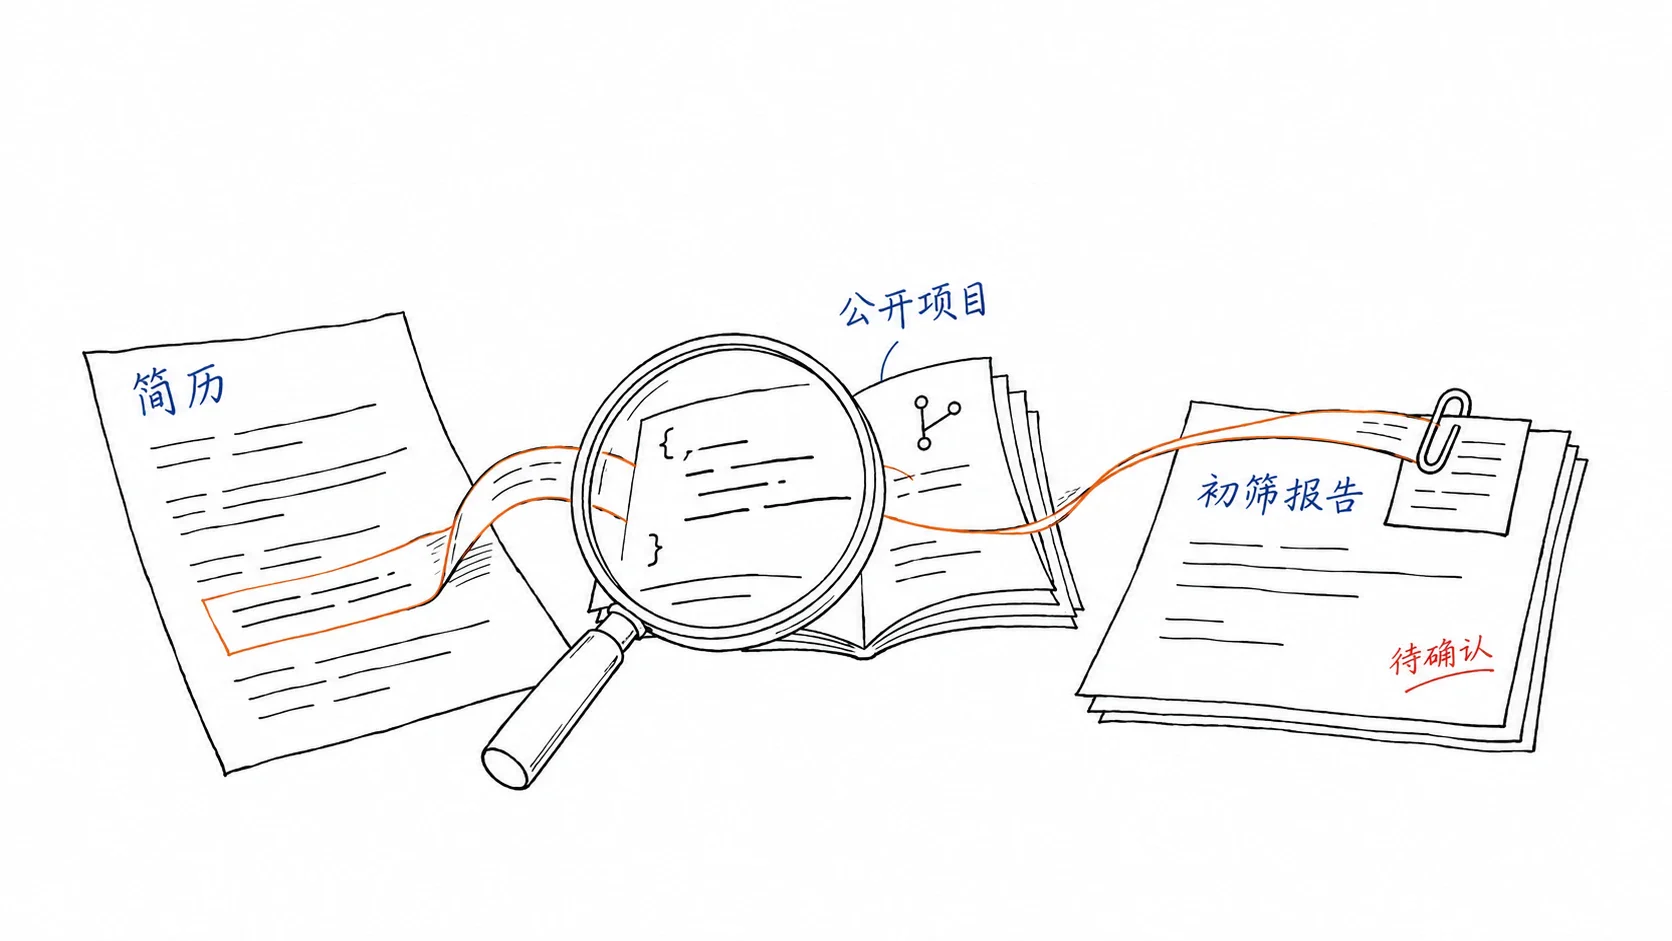 从简历里的项目线索查到公开材料,保留在初筛报告中
用 Jev 辅助判断是否值得面试
我结合岗位要求和简历质量设置评估标准,把分析、分数和对应的简历原文放在报告里,方便比较和排序。
我接入了评估模型 Jev,让语言模型先整理分析和原文依据,再由 Jev 按标准评分。我拿同样的样本做对比:直接让 LLM 评分,分数会有浮动;Jev 出来的分数几乎完全一样,这点我挺满意。
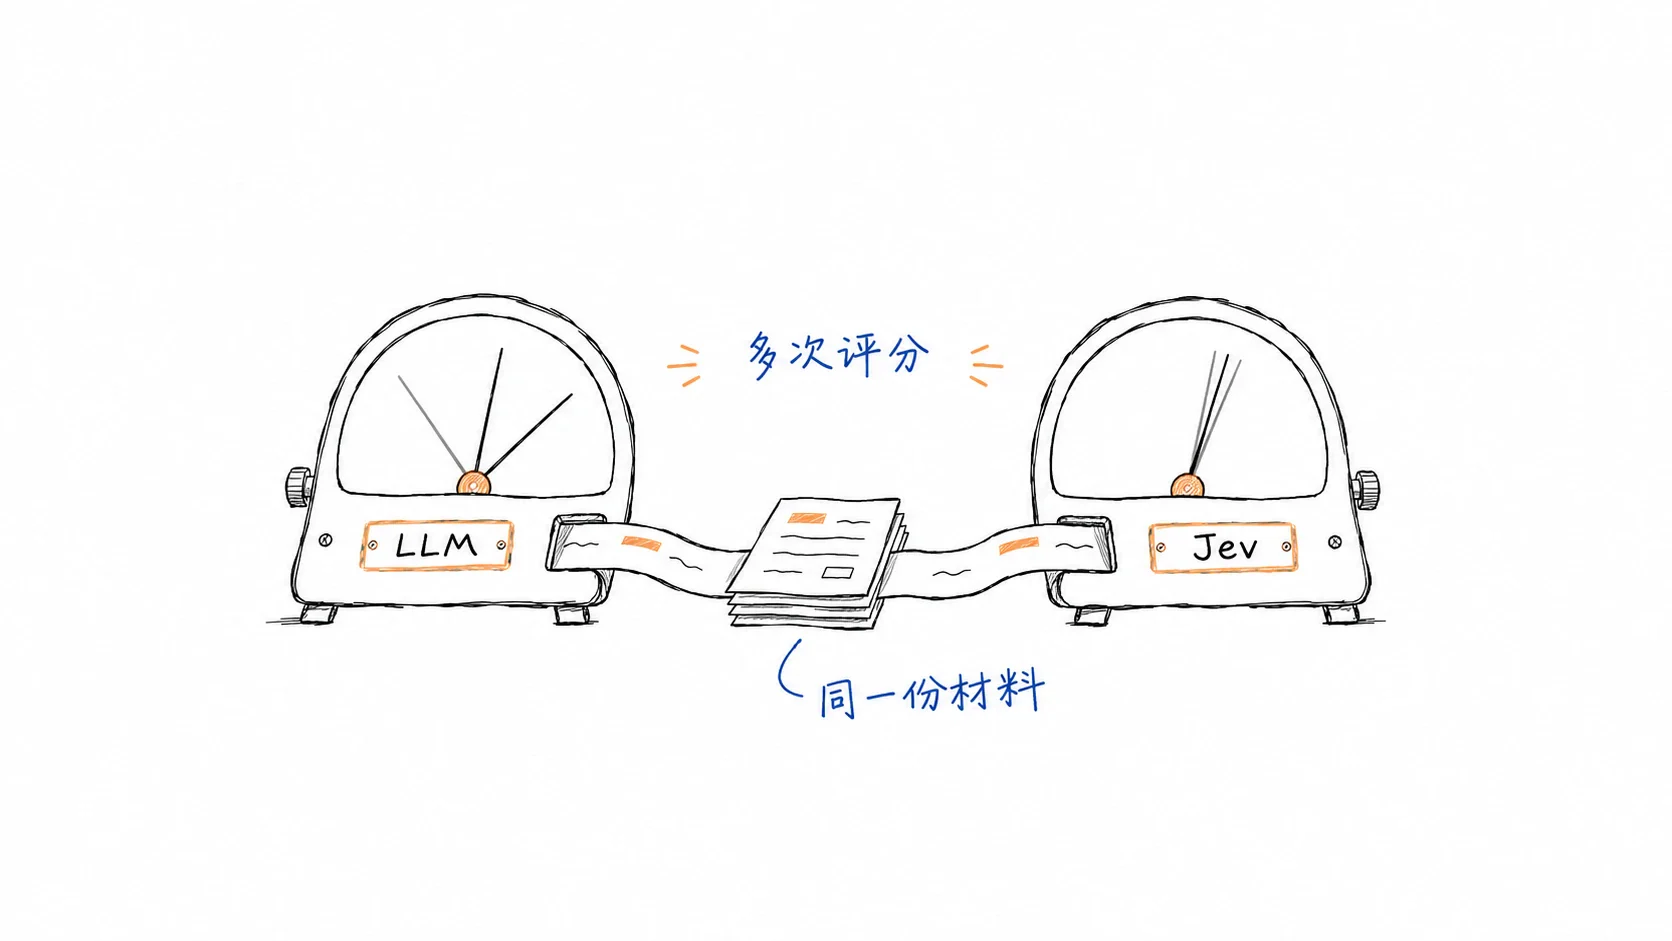 我用同样的样本多次对比,Jev 的评分几乎完全一样
面试准备与后续评估
报告里能看到初评、公开项目的发现、亮点和待确认的问题。我让 AI 结合这些材料和岗位要求生成面试题,附上考察点、答案要点和追问。出题偏好可以配置,也能从自己维护的题库里选题。
初筛后,我可以直接和内置 Agent 接着聊,它能读取已有的简历和报告。面试后也能导入会议纪要,作为进一步评估人选的材料。
报告和原简历可以一起导出为 PDF,方便发给 HR 或参与面试的同事。
候选人多起来后,我把前端做成了支持表格、看板和保存视图的工作台,可以筛选、排序,再打开侧栏看简历和报告。
报告里的判断需要修改时,我可以补充人工意见,重跑时继续保留。需要重查哪部分,就选择对应阶段,每次运行的历史也能回看。