用过几个 coding agent 之后,聊天记录也分散在了几个地方。一个需求在 Codex 里聊过,另一个决定可能留在 Claude 或 Pi 的会话里。过段时间想找,往往记得大概说了什么,却不记得该去哪里翻。
Agentlog 是我用来收这些记录的工具。它读取各个 Agent 已经保存在本机的历史,整理成一份普通目录。我可以自己搜索,也可以把只读 MCP 接给后续的 Agent,让它先查之前做过什么。
找回原话与上下文
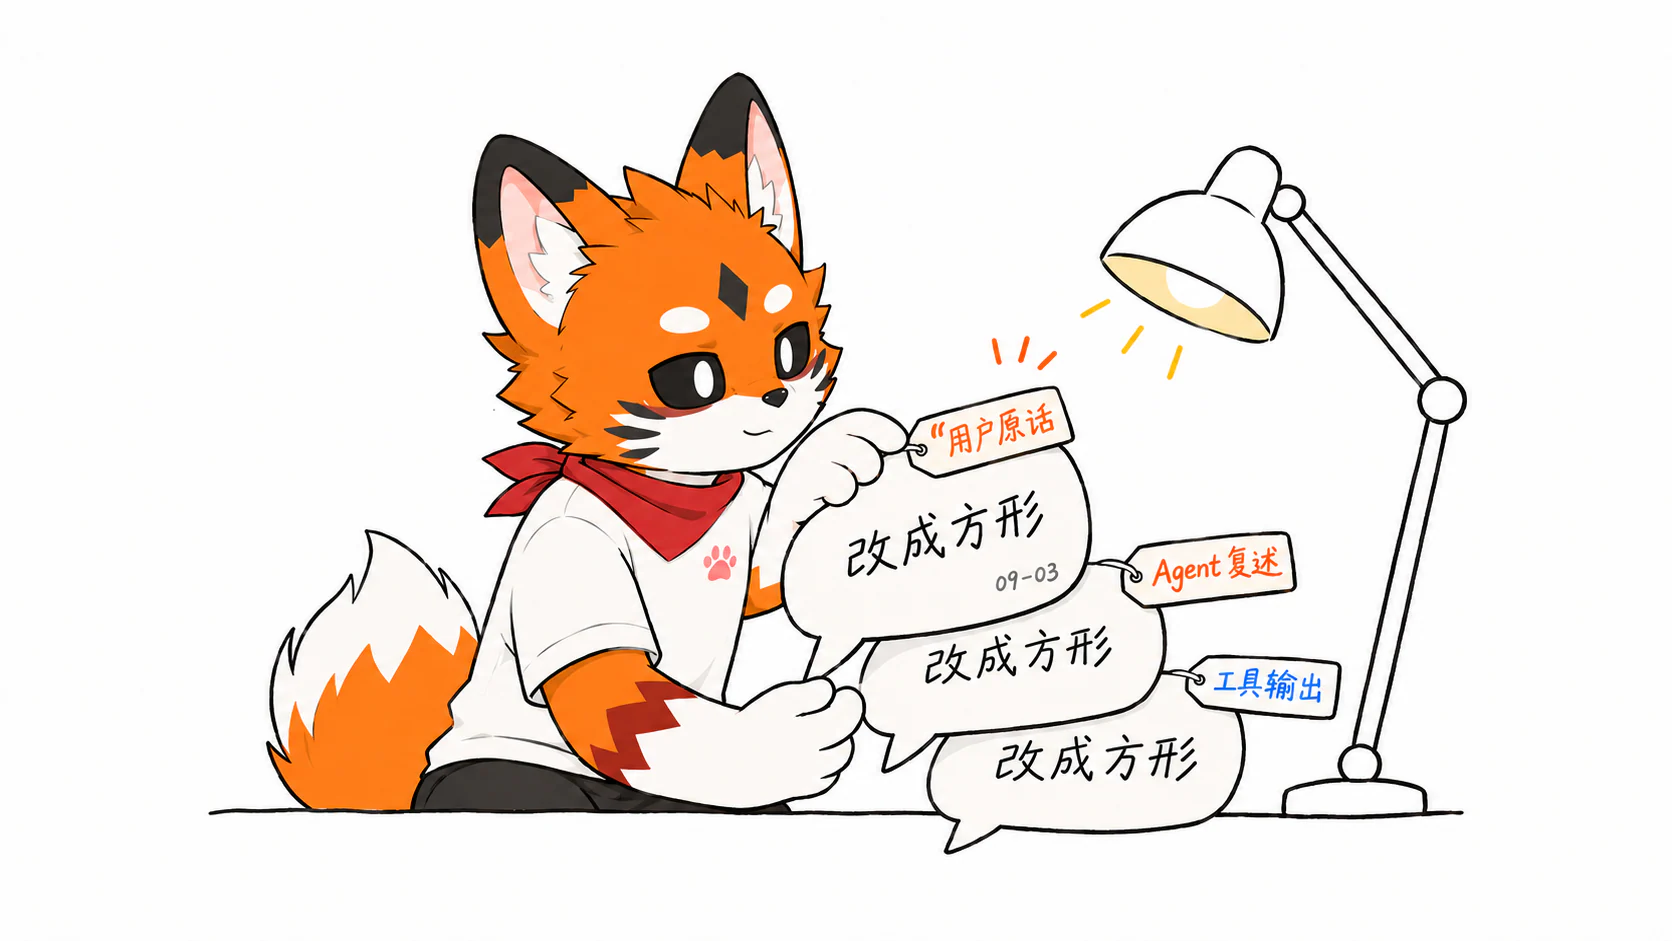
早期只搜字面内容,很容易找到一段看起来相关的文字,但同样的话可能来自用户、Agent 的复述,也可能是工具输出。尤其是一次需求被几轮交接摘要重复引用后,搜索结果会挤满重复内容。
我后来给检索加了发言来源、项目、时间和工具来源等条件。找自己的原话时,可以先筛出用户消息,再读附近的对话,确认当时在讨论什么。重复片段合并显示,其他出现位置仍然保留。
例如,在命令行查某个项目的设计记录:
agentlog search '封面' --repo blog --jsonMCP 提供的也是这一类入口:先用 search_sessions 找会话和片段,再用 session_context 看附近消息,或者用 read_evidence 读取原文。引用带有内容版本,归档改变后,读取方可以发现手里的定位已经过期。
归档不同 Agent 的聊天记录
目前有 Claude、Codex、Pi、Cursor、OpenCode、Grok 和 Kimi 七个来源适配器。它们的目录、消息格式和附带信息各不相同,适配器负责读取,后面统一写入 Store。
Store 里,完整对话是一行一条消息的 JSONL,每个会话另有一份卡片,保存标题、工作目录、更新时间等信息。摘要和索引是之后生成的资料,和原始归档分开放。
Store/
  chats/             完整对话
  index/             会话卡片
  derived/           摘要、目录与检索资料
  progress.sqlite    增量处理进度
再次归档时,没变化的会话跳过,有变化的更新。保留普通文件的形式,是为了以后换工具时仍然能读,也方便备份和直接搜索。
按任务整理长会话
长会话不一定只属于一个项目,项目也不一定只占一个会话。我给摘要增加了目录和任务分段,再把相关任务归到工作主题下,记录哪些是同一件事的继续,哪些依赖另一项工作。
这一层最容易出现的问题,是摘要说得通,归类却不符合我实际做事的方式。因此,工作主题旁边仍然保留原文依据,也有改名、合并和隐藏关系的整理入口。人的修改独立保存,后续重新生成时继续保留。
增量生成摘要
归档会不断增长,一次处理完所有历史并不现实。摘要部分因此有增量缓存、并发和预算限制、取消、重试与运行记录。最近接入 Pi 摘要后端时,我也把目录生成、工作主题整理和发布组织成可以恢复的分阶段任务。
我仍然会拿真实会话看摘要质量:有没有把想法写成已经完成,有没有漏掉后来的更改,有没有把 Agent 的猜测当成我的决定。整理这份作品集时,我也在用 Agentlog 查记录,找出值得写进项目页的细节。
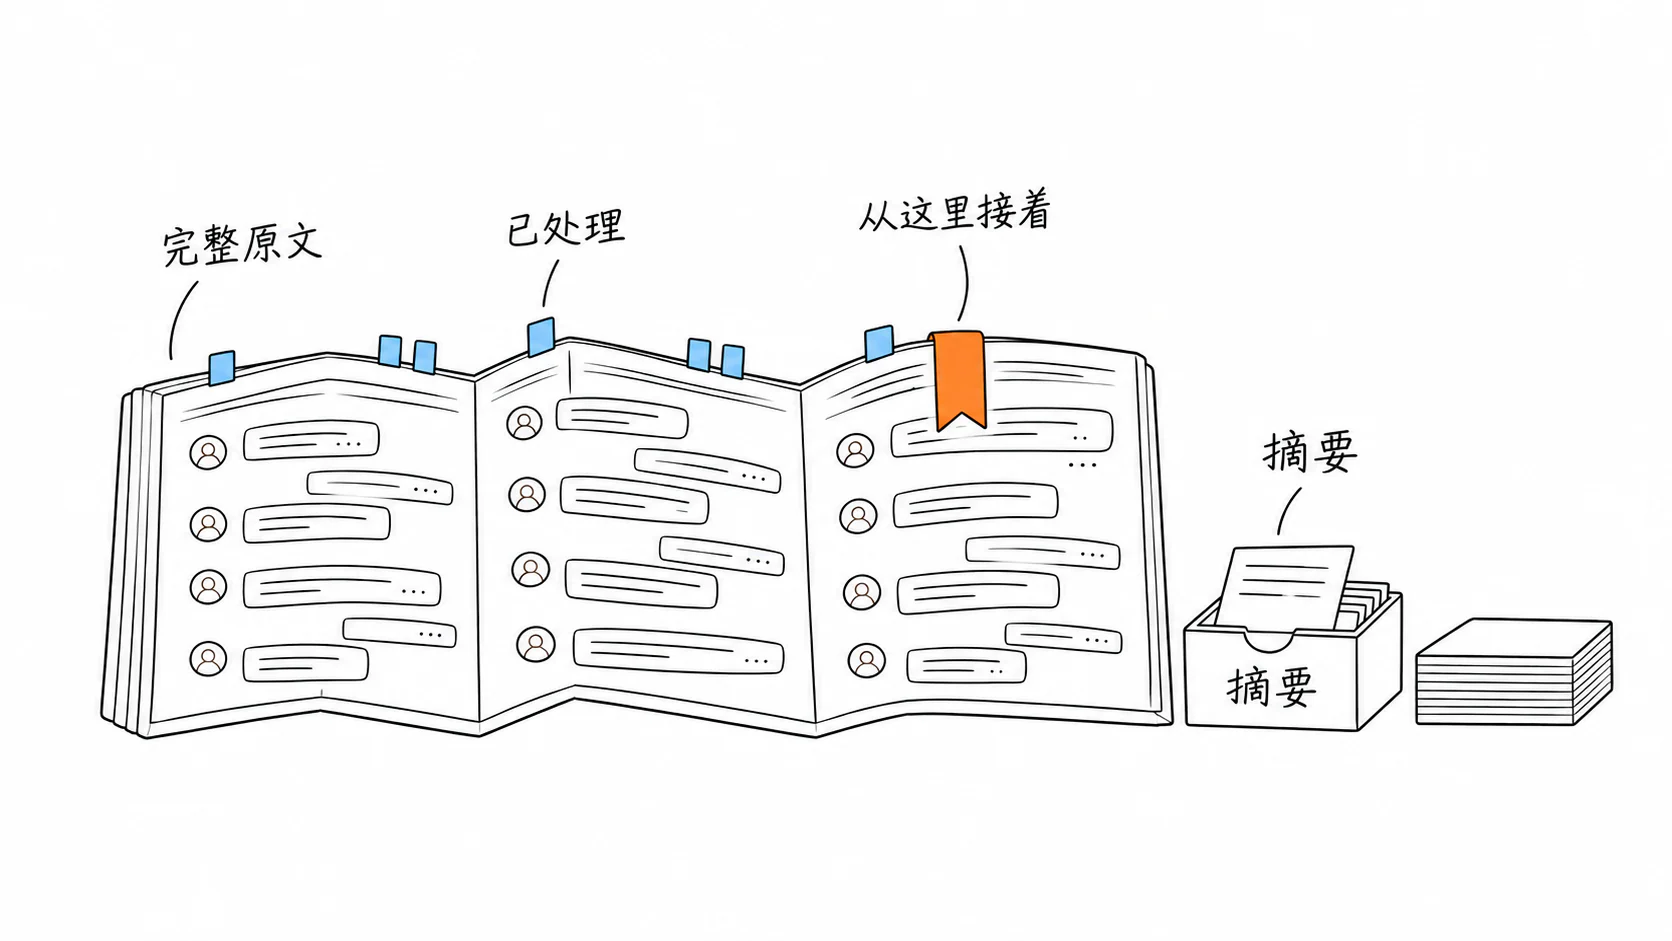 保留完整原文与处理进度,中断后从留下的位置接着整理摘要